 뒤로
Descriptive Statistics, Data Types, and Bivariate Analysis: Foundations for Introductory Statistics
스터디 가이드 - 스마트 노트
 자료에 맞춘 맞춤형 노트, 핵심 정의, 예시, 맥락을 확장해 제공합니다.
Descriptive Statistics & Data Collection
Why Statistics?
Statistics is the science of turning observations into actionable decisions. In business, research, and consulting, statistics helps answer questions about what is happening, for whom, and how much variation exists. A useful analysis connects a question, a variable, an output, and a decision.
Research: Identifies patterns and variation.
Business: Guides action and monitoring.
Consulting: Provides evidence and interprets meaning.
The Evidence Workflow
Statistical analysis follows a structured workflow:
Question: Define what needs to be known.
Cases: Identify who or what is observed.
Variables: Determine how each concept is measured.
Description: Detect patterns in the data.
Communication: Draw responsible conclusions.
Defining and Collecting Data
Data Structure
In a dataset, each row represents a case (e.g., a customer transaction), each column represents a variable (e.g., region, satisfaction), and each cell contains a recorded value.
Measurement Levels
The type of variable determines the analysis, not its appearance:
Nominal: Categories without order (e.g., channel, region). Summarized by counts, percentages, and mode.
Ordinal: Ordered categories (e.g., satisfaction ratings). Summarized by counts, percentages, and median.
Quantitative (Scale): Numeric values (e.g., basket value, wait time). Summarized by mean, median, standard deviation (SD), and interquartile range (IQR).
Organizing and Visualizing Variables
Univariate Analysis: Qualitative Variables
Categorical analysis answers questions about frequency and proportion:
Count: = number of cases in category
Percentage:
Mode: Most frequent category
Common chart types include sorted bar charts, 100% stacked bars, horizontal bars, and pie charts (used sparingly).
Univariate Analysis: Quantitative Variables
Quantitative analysis requires measures of center and spread:
Mean: Arithmetic average, sensitive to outliers.
Median: Middle value, robust to extremes.
Mode: Most common value.
Range: Difference between maximum and minimum.
IQR: Spread of the middle 50% ().
Standard Deviation (SD): Typical distance from the mean.
Coefficient of Variation (CV):
Choice of summary depends on data shape: mean for symmetric data, median for skewed or outlier-prone data.
Population vs. Sample Mean
The mean is calculated differently for populations and samples:
Population Mean:
Sample Mean:
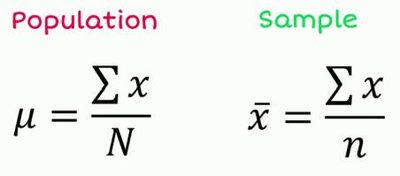
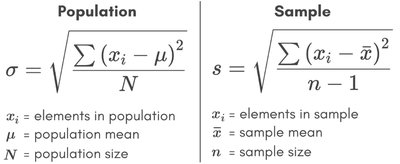
Population vs. Sample Standard Deviation
Standard deviation measures spread, with formulas differing for population and sample:
Population SD:
Sample SD:
Visual Summaries
Bar Chart: For categorical variables.
Histogram: For quantitative variables, shows distribution shape.
Boxplot: Visualizes the five-number summary (min, Q1, median, Q3, max) and identifies outliers.
Numerical Descriptive Measures
Worked Example: Mean vs. Median
One extreme value can shift the mean but not the median, highlighting the importance of inspecting distribution shape before choosing a summary statistic.
Dispersion Measures
Range:
IQR:
Sample SD:
Coefficient of Variation:
Bivariate Analysis
Bivariate Roadmap
The types of two variables determine the appropriate analysis:
Qualitative × Qualitative: Crosstab and conditional percentages.
Qualitative × Quantitative: Group summaries and boxplots.
Quantitative × Quantitative: Scatterplot and correlation.
Crosstabs
Crosstabs reveal how one categorical distribution changes across another. Conditional percentages (row, column, total) clarify the direction of comparison.
Group Comparisons
Comparing quantitative variables across groups involves examining means/medians, spread (SD/IQR), sample sizes, and overlap in distributions.
Scatterplots and Correlation
Scatterplots show direction, form, strength, and anomalies in the relationship between two quantitative variables. Pearson correlation () standardizes co-movement:
Covariance:
Pearson correlation: ,
Correlation captures linear association but not causality or nonlinear relationships.
Sampling and Inference
Sample vs. Population
Descriptive statistics summarize observed data (sample), while inferential statistics estimate population parameters and quantify uncertainty.
Sources of Bias
Sampling variability: Different samples yield different estimates.
Coverage bias: Some population members cannot be selected.
Nonresponse: Respondents differ from nonrespondents.
Measurement error: Recorded values may not match intended concepts.
Generalization Checklist
Target population: Who should the result describe?
Sampling design: How were cases selected?
Uncertainty method: How variable is the estimate across samples?
Summary Table: Variable Types and Summaries
Variable | Numerical Summary | Visual Summary |
|---|---|---|
Channel | Counts, percentages, mode | Bar chart |
Satisfaction 1–5 | Counts, percentages, median | Ordered bar |
Basket value | Mean/median + SD/IQR | Histogram + boxplot |
Conclusion
Descriptive statistics provide the foundation for understanding data, guiding responsible communication, and preparing for inferential methods such as probability, sampling distributions, confidence intervals, and hypothesis testing.
